模型

Goku

Goku是由香港大学与字节跳动联合开发的AI视频生成模型,支持文本到图像、文本到视频、图像到视频等多种生成方式。其核心优势在于高质量的视频输出、低制作成本及多模态生成能力。Goku+作为扩展版本,专注于广告视频创作,具备稳定的动作表现和丰富的表情交互。模型基于大规模数据集和先进架构,适用于广告、教育、娱乐等多个领域,提升了内容创作效率与质量。

SPRIGHT

SPRIGHT是由多所高校和机构联合开发的视觉-语言数据集,旨在提升文本到图像生成模型的空间一致性。通过重新描述约600万张图像,强化空间关系表达,如“左/右”、“上/下”等,显著提高图像生成的准确性。该数据集支持复杂场景的图像生成,并经过多维度评估验证其可靠性。SPRIGHT为视觉-语言模型的研究和应用提供了重要资源,广泛应用于图像生成、VR/AR、教育及科研等领域。

蓝心大模型

蓝心大模型是由vivo研发的通用大模型矩阵,包括语言、端侧、语音、图像及多模态模型。该模型在内容创作、知识问答、逻辑推理、代码生成、信息提取、多语言翻译等方面表现出色。蓝心端侧大模型3B在移动设备上表现出色,蓝心语音大模型支持多语言,蓝心图像大模型融合了中国特色和东方美学,蓝心多模态大模型则提供了流畅的视频对话体验。

ScreenAI

ScreenAI是一款专为理解和处理用户界面(UI)及信息图表而设计的AI视觉语言模型。它能够识别和理解UI元素及其相互关系,并生成与屏幕UI元素相关的文本,如问题回答、UI导航指令和内容摘要。ScreenAI通过多模态编码器结合视觉和语言信息,并采用自回归解码器生成自然语言响应。此外,ScreenAI还能适应不同屏幕格式,提供精确的UI导航和内容摘要功能。

AvatarFX

AvatarFX是由Character.AI开发的AI视频生成工具,通过上传图片和选择语音,可生成角色说话、唱歌和表达情感的动态视频。支持多角色、多轮对话及长视频生成,具备高时间一致性。采用扩散模型与音频条件化技术,确保动作与语音同步。适用于互动故事、虚拟直播、娱乐表演及教育内容创作,提供高效、高质量的视频生成体验。

TechGPT-东北大学

TechGPT是一个强大的垂直领域大语言模型,具备处理专业领域文本的能力,并在信息抽取、智能问答和序列生成等方面表现出色。
Shots.So

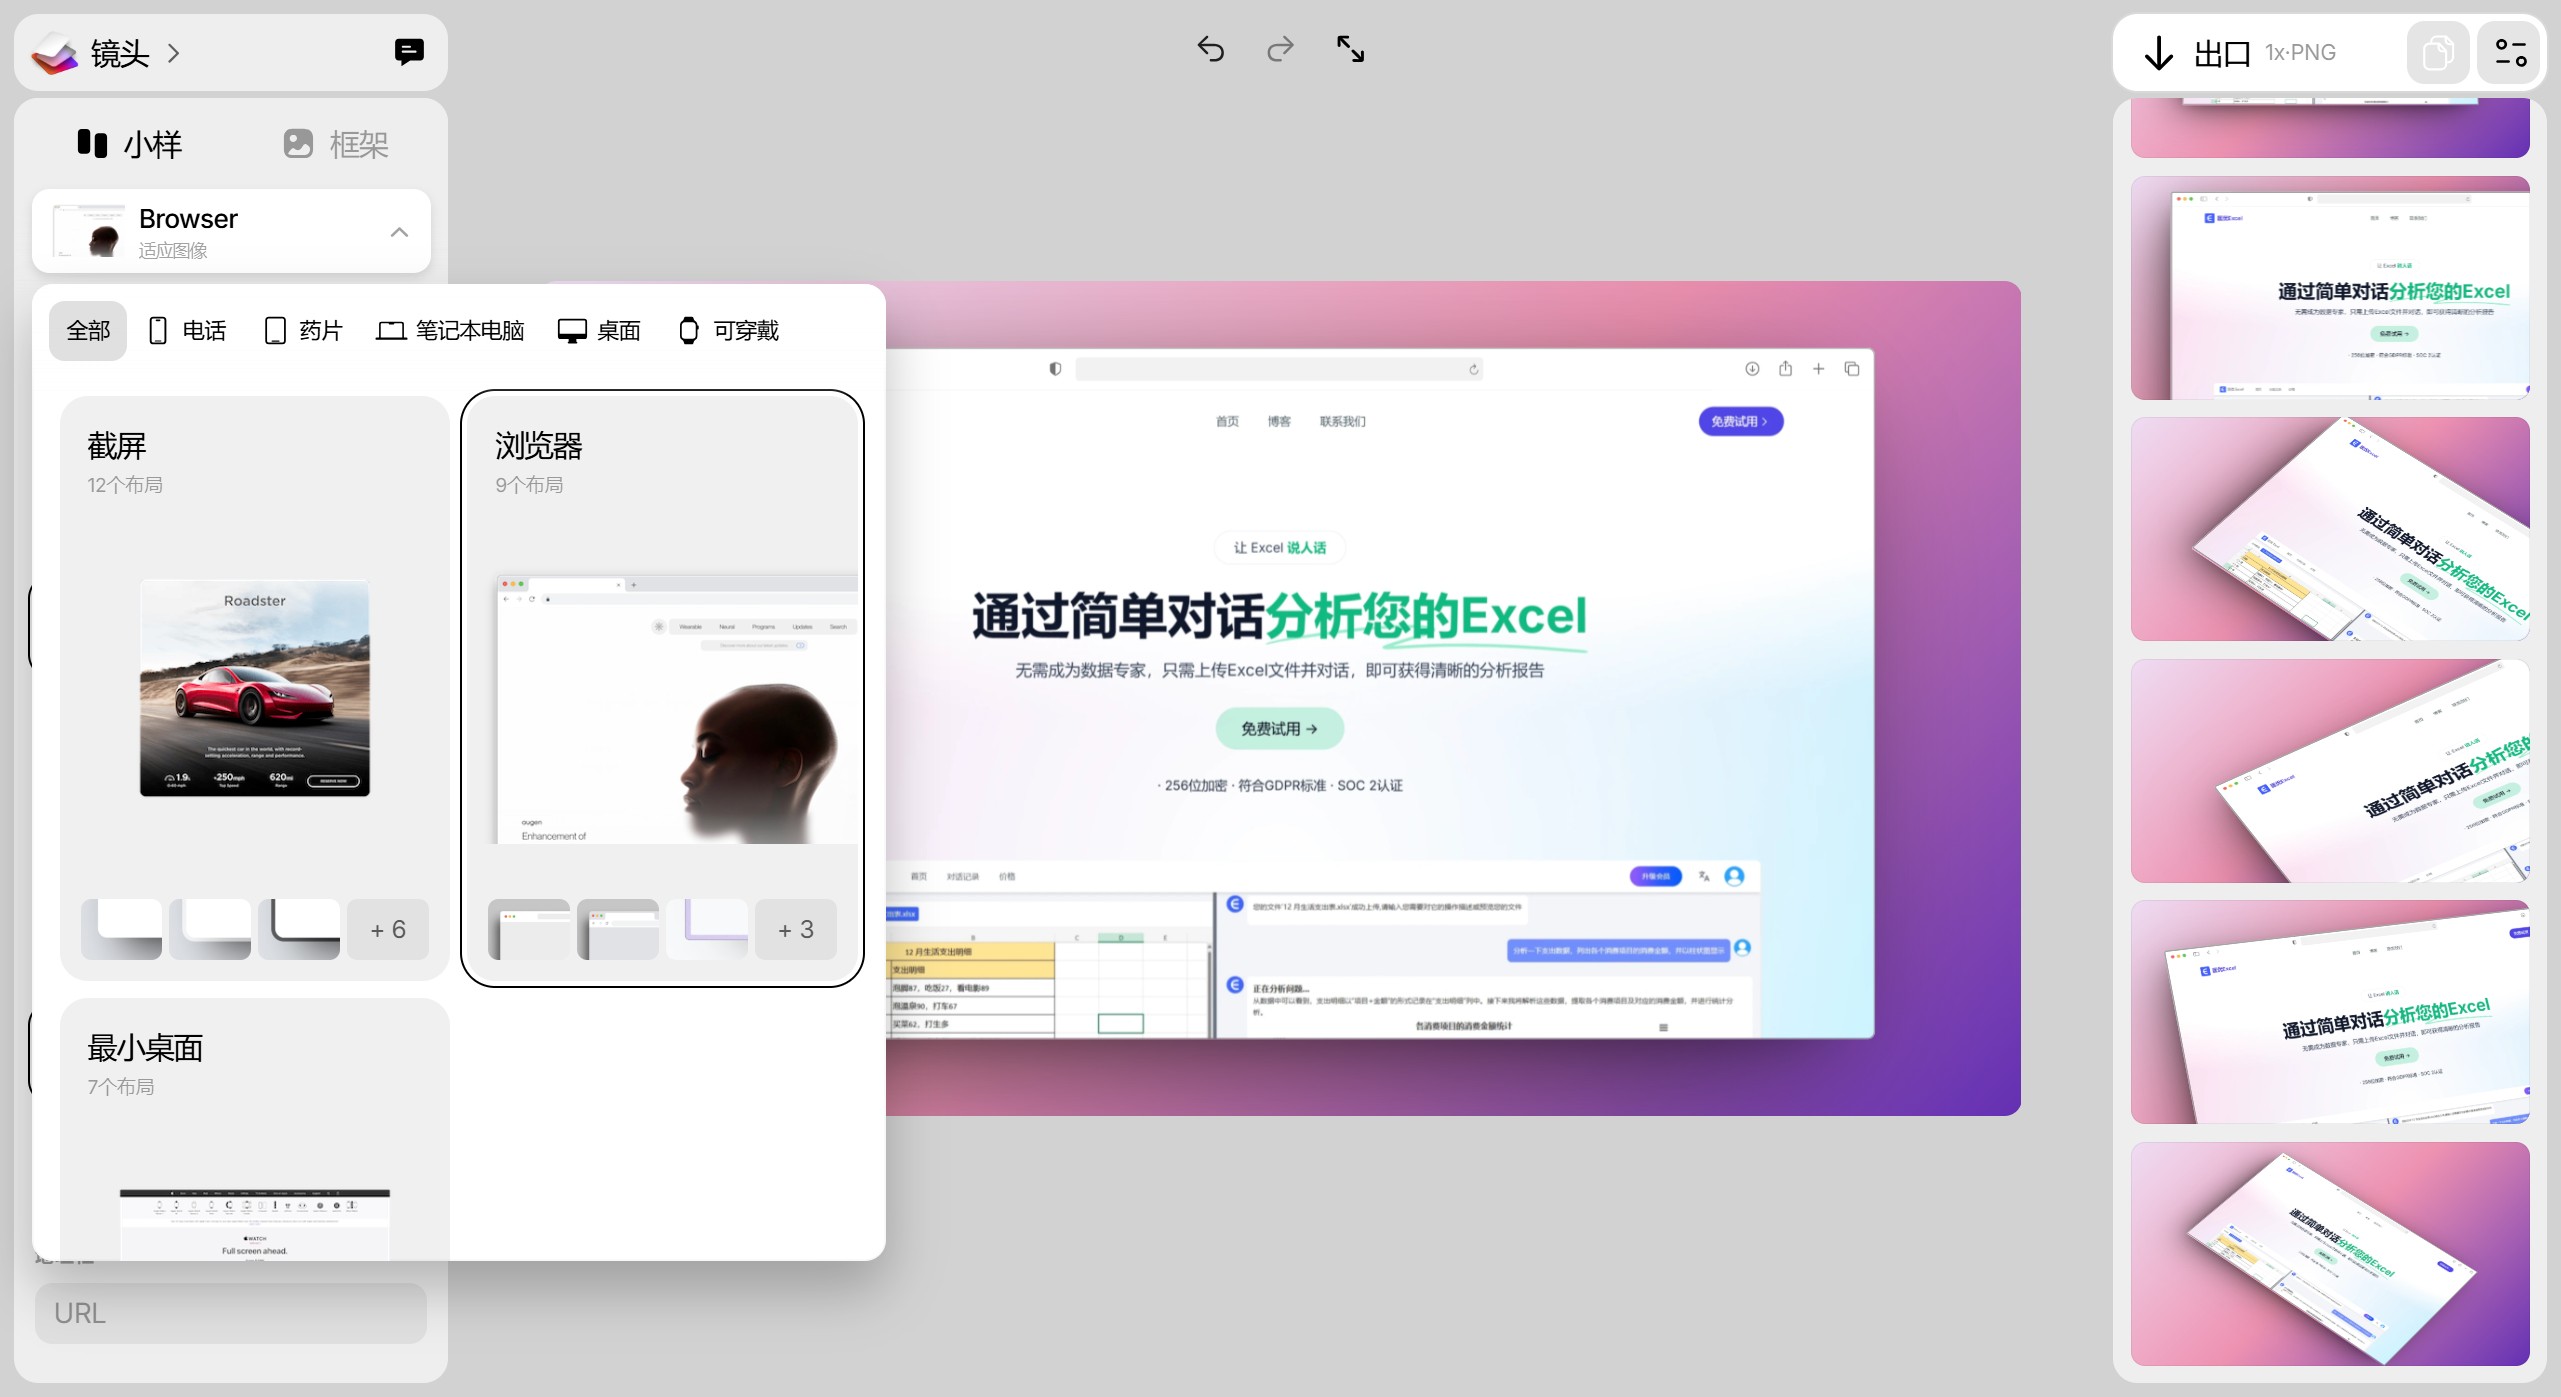
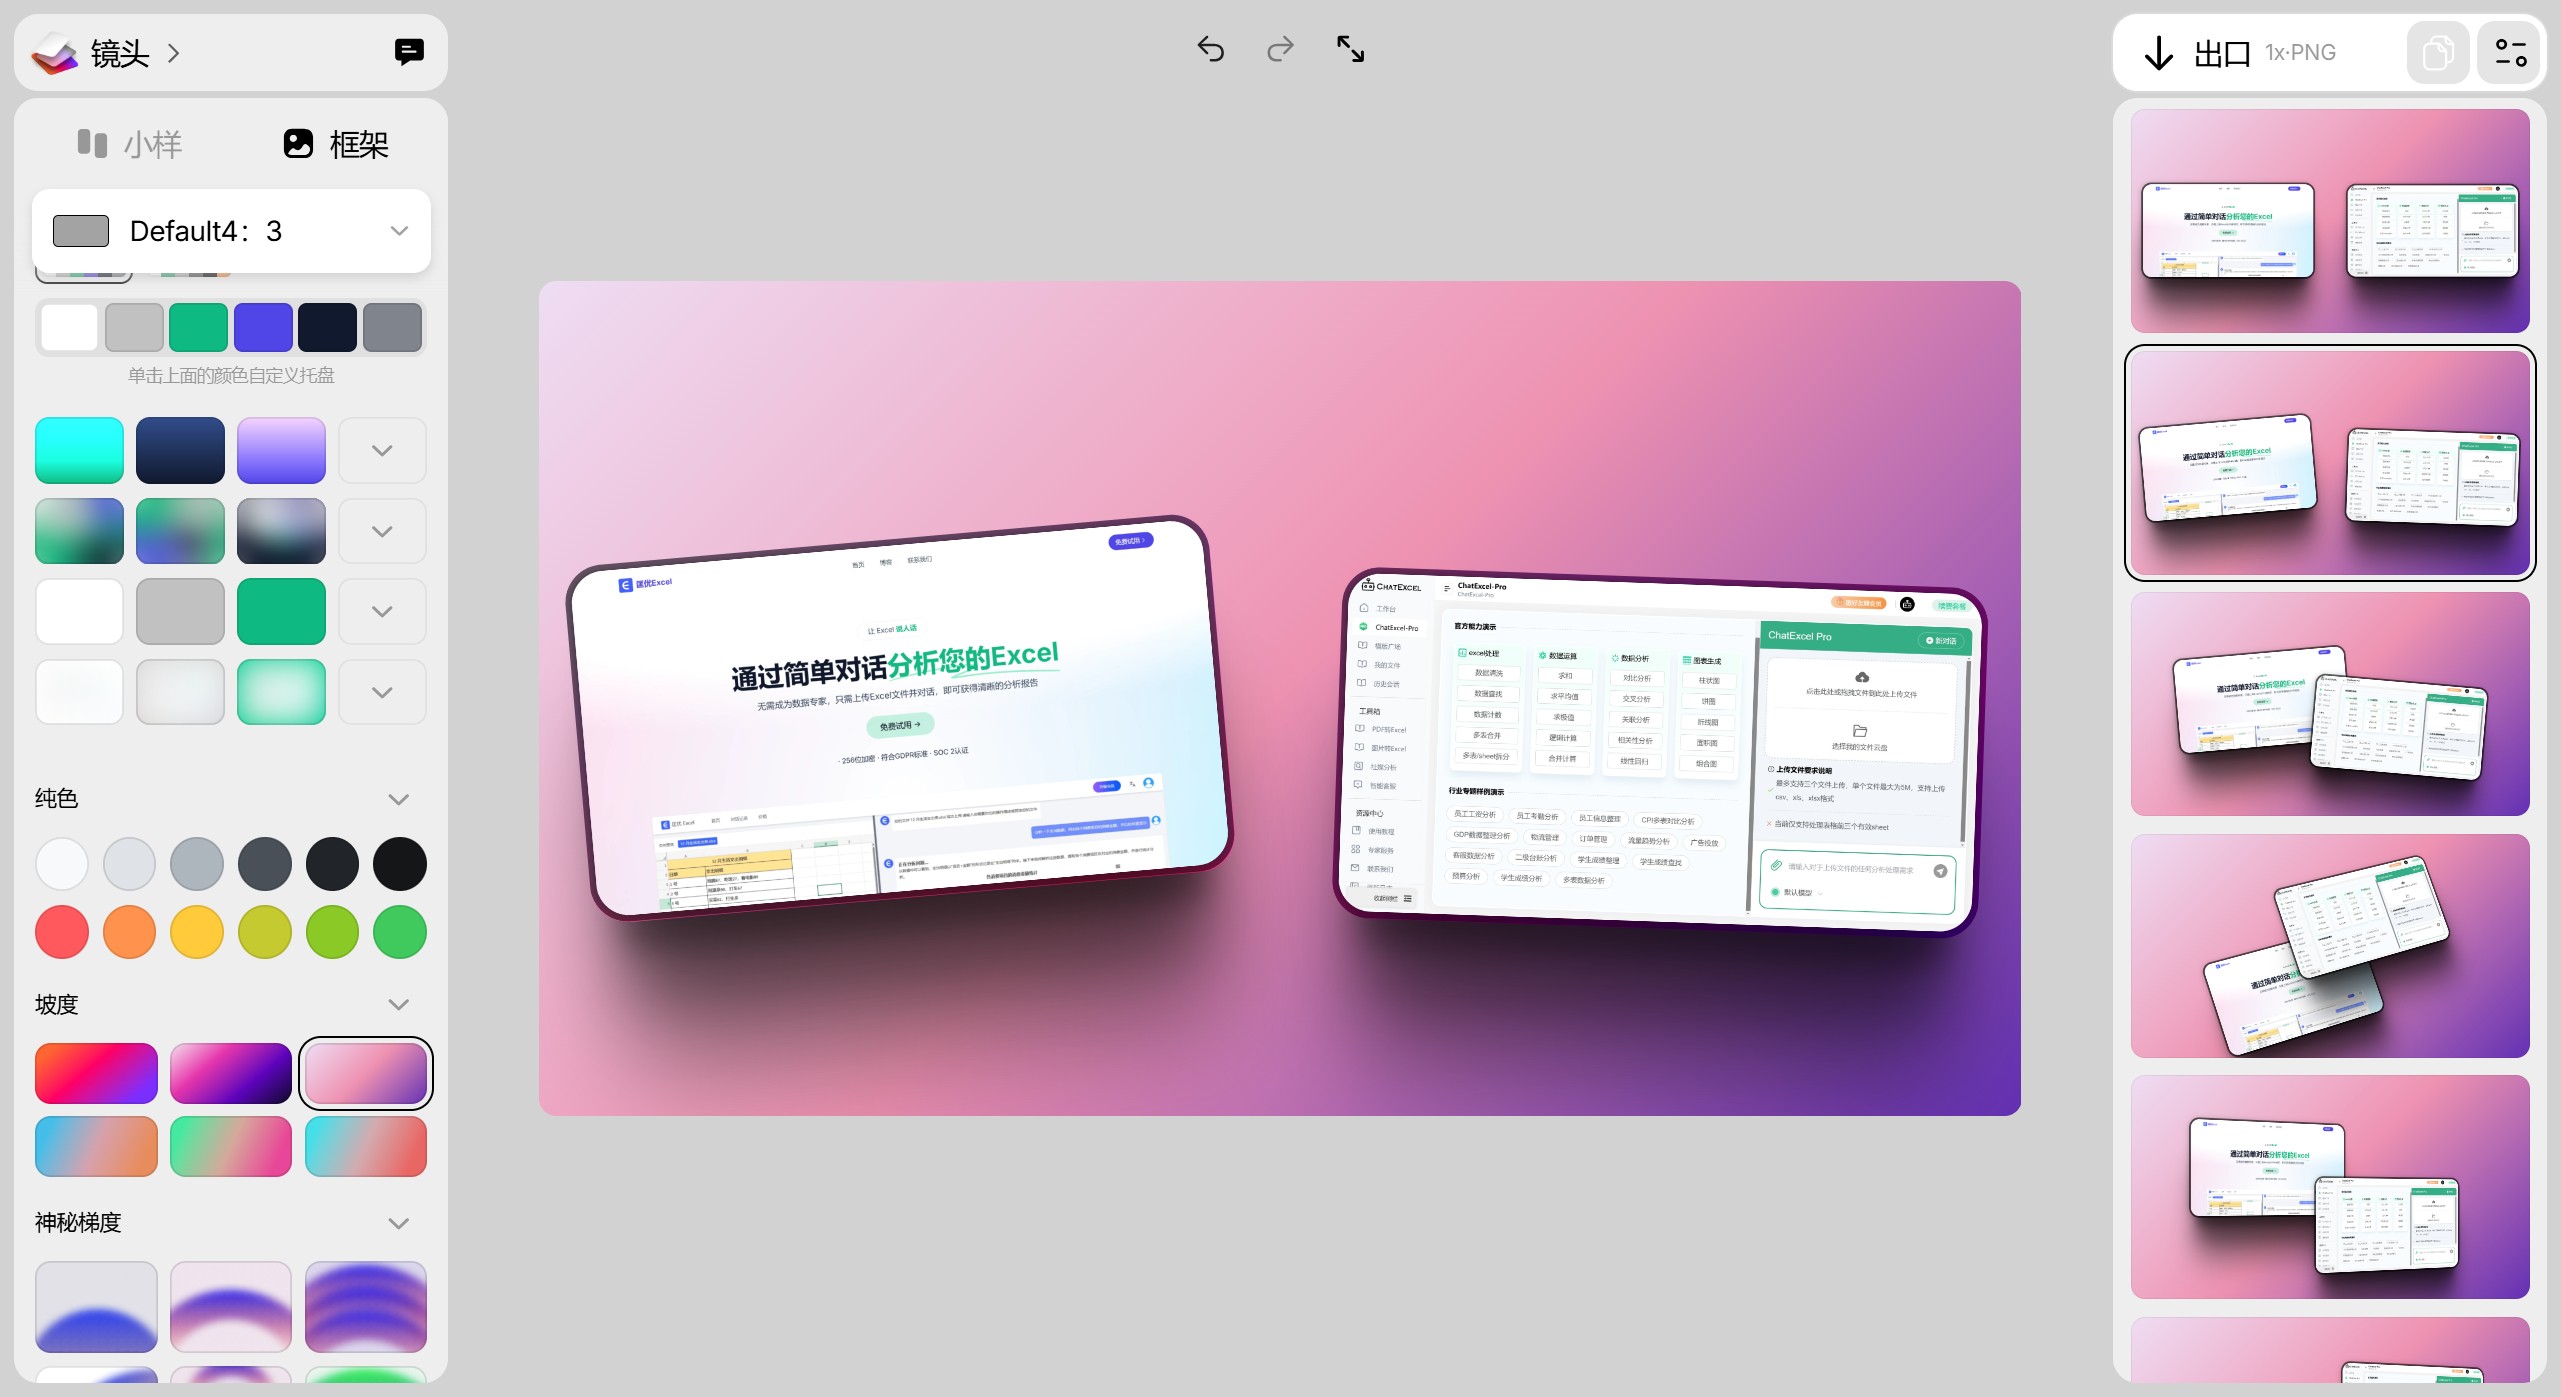
一个免费的在线工具,只需点击几下即可帮助您创建漂亮的样机模型。 Shots.so可以与背景框架和不同的模型(如浏览器、手机、笔记本电脑、手表等)产生很好的效果。

MagicVideo

MagicVideo-V2是一款由字节跳动公司团队开发的AI视频生成模型和框架。该模型通过集成文本到图像模型、视频运动生成器、参考图像嵌入模块和帧插值模块,实现了从文本到高保真视频的转换。生成的视频不仅具有高分辨率,而且在视觉质量和运动流畅度方面表现出色,为用户提供卓越的观看体验。

Nemotron

Nemotron-Mini-4B-Instruct是一款由英伟达开发的小型开源语言模型,针对角色扮演、检索增强生成(RAG)及函数调用任务进行了优化。模型基于Transformer架构,利用蒸馏、剪枝和量化技术提升运行效率与设备端适配能力,适用于实时交互场景,如游戏NPC对话或虚拟助手交互。其快速响应特性使其在客户服务、教育软件及内容创作领域也展现出巨大潜力。

Sketch2Sound

Sketch2Sound是一种由Adobe研究院与西北大学联合开发的AI音频生成技术,通过提取响度、亮度和音高概率等控制信号,结合文本提示生成高质量音效。其轻量化设计使得模型易于适配多种文本到音频框架,同时赋予声音设计师更强的表达力与可控性,广泛适用于电影、游戏、音乐制作及教育等多个领域。