模型

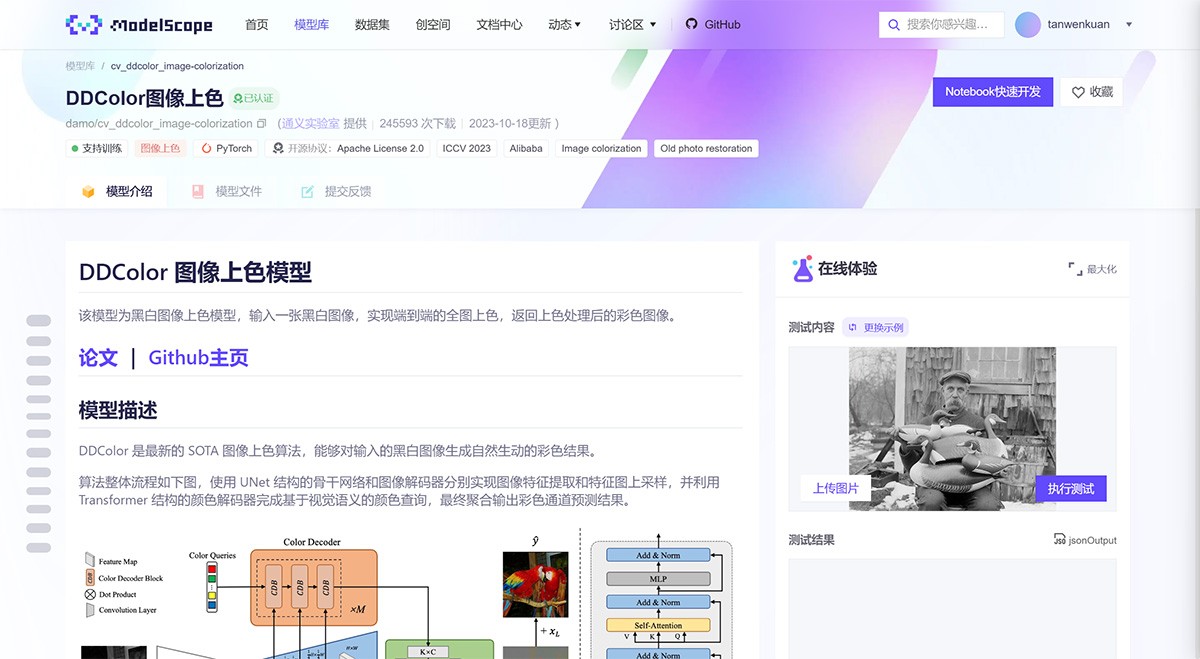
DDColor图像上色

一个为黑白图像上色的魔搭模型,通过双解码器实现逼真的图像着色,输入一张黑白图像,实现端到端的全图上色,返回上色处理后的彩色图像。

LangManus

LangManus 是一款基于多智能体系统的 AI 自动化框架,支持多种语言模型和 API 接口,具备高效的网络与神经搜索能力。框架内含多种智能体协同工作,可完成任务分配、规划、执行与报告生成。支持代码编写与执行、任务可视化及实时监控,适用于人力资源、房产决策、旅行规划、内容创作和教育开发等多个领域。

Lobe

Lobe通过一个免费、易于使用...

VideoRefer

VideoRefer是由浙江大学与阿里达摩院联合开发的视频对象感知与推理系统,基于增强型视频大型语言模型,实现对视频中对象的细粒度理解与分析。其核心包括大规模视频数据集、多功能空间-时间编码器和全面评估基准,支持对象识别、关系分析、推理预测及多模态交互等功能,适用于视频剪辑、教育、安防、机器人控制和电商等多个领域。

Voyage Multimodal

Voyage Multimodal-3 是一款多模态嵌入模型,能够处理文本、图像以及它们的混合数据,无需复杂文档解析即可提取关键视觉特征。它在多模态检索任务中的准确率显著高于现有最佳模型,支持语义搜索和文档理解,适用于法律、金融、医疗等多个领域的复杂文档检索任务。

琴乐大模型

琴乐大模型是一款由腾讯AI Lab与腾讯TME天琴实验室联合开发的人工智能音乐创作工具。该工具能够根据用户输入的关键词、描述性语句或音频,生成高质量的立体声音频或多轨乐谱,并支持自动编辑功能。琴乐大模型采用先进的技术框架,包括音频文本对齐、乐谱/音频表征提取、大语言模型预测以及流匹配和声码器技术,确保生成的音乐符合音乐理论和人类审美标准。

Claude 3

Claude 3是由Anthropic开发的一系列先进的人工智能模型,旨在提供强大的认知能力和处理复杂任务的能力。该模型家族包括Claude 3 Haiku、Claude 3 Sonnet和Claude 3 Opus,它们分别针对不同的应用场景进行了优化。Claude 3 Opus在多个基准测试中超越了GPT-4/3.5和Gemini 1.0 Ultra/Pro,展示了其在智能水平上的显著优势。该

文心智能体平台

百度推出的一个基于文心大模型的AI智能体(Agent)平台,文心智能体平台旨在支持广大开发者根据自身行业领域、应用场景,选取不同类型的开发方式,打造大模型时代的产品能力。

Llasa TTS

Llasa TTS是基于LLaMA架构的开源文本转语音模型,支持高质量语音合成、情感表达和音色克隆。采用单层VQ编解码器和Transformer结构,具备多语言支持及长文本处理能力,适用于智能助手、有声读物、游戏娱乐等场景。模型提供不同参数规模版本,支持零样本学习,提升语音自然度和表现力。
