多模态

FlexIP

FlexIP 是腾讯推出的图像合成框架,支持在保持主体身份的同时进行个性化编辑。其双适配器架构分离身份保持与编辑功能,结合动态权重门控机制实现灵活控制,并通过多模态数据训练提升生成质量与稳定性,适用于艺术创作、广告设计、影视制作等多个领域。

Reka Flash 3

Reka Flash 3 是一款由 Reka AI 开发的开源推理模型,拥有 21 亿参数,支持多模态输入(文本、图像、视频、音频),并可处理最长 32k 个令牌的上下文。它具备高效的推理能力和多语言支持,适用于日常对话、编码辅助、指令执行等多种场景。模型可在本地部署,支持 4 位量化以降低资源占用,适合广泛的应用需求。

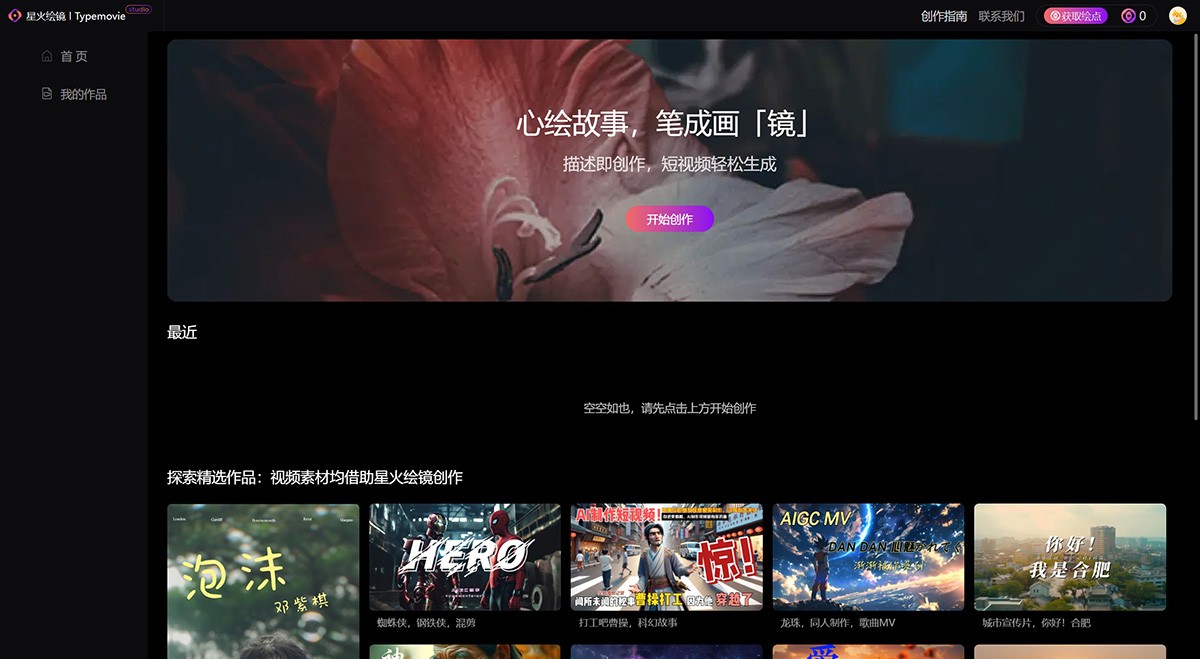
星火绘镜

一款由科大讯飞推出的AI文生视频创作平台,可以轻松地从文字描述生成短视频内容、将文本转换为视频分镜、扩展成完整的短视等。

心影大模型

心影大模型是一款专注于游戏领域的AI工具,基于超百万条游戏数据训练,支持《原神》《艾尔登法环》等主流游戏,提供精准攻略查询、情感化角色互动、多模态交互等功能。其响应速度快,准确率高,适用于游戏辅导、情绪支持、心理陪伴等多种场景,提升用户体验与互动性。

QVQ

QVQ是一个基于Qwen2-VL-72B的开源多模态推理模型,擅长处理文本、图像等多模态数据,具备强大的视觉理解和复杂问题解决能力。它在数学和科学领域的视觉推理任务中表现出色,但在实际应用中仍需解决语言切换、递归推理及图像细节关注等问题。QVQ可广泛应用于教育、自动驾驶、医疗图像分析、安全监控及客户服务等领域。

3D

3D-Speaker是一个多模态开源项目,专注于通过结合声学、语义和视觉信息,实现高精度的说话人识别和语种识别。其主要功能包括说话人日志、说话人识别、语种识别、多模态识别以及重叠说话人检测。项目提供了工业级模型、训练与推理代码,以及多样化数据集,并支持复杂环境下的语音处理任务。应用场景涵盖会议记录、法庭记录、广播制作、电话客服和安全监控等领域。

NEXUS

NEXUS-O是一款由多家知名机构联合开发的多模态AI模型,能够处理音频、图像、视频和文本等多种输入,并以相应形式输出结果。它在视觉理解、音频问答、语音识别和翻译等方面表现出色,具备强大的跨模态对齐与交互能力。模型基于视觉语言预训练,结合高质量音频数据提升性能,并通过多模态任务联合训练增强泛化能力。适用于智能语音助手、视频会议、教育、智能驾驶、医疗健康等多个领域。

LLMDet

LLMDet是一款基于大型语言模型协同训练的开放词汇目标检测器,能够识别训练阶段未见过的目标类别。其通过结合图像和文本信息,实现高精度的零样本检测,并支持图像描述生成与多模态任务优化,适用于多种实际应用场景。
