图像

UniToken

UniToken 是一种面向多模态理解与生成任务的自回归模型,结合了离散与连续视觉表示,实现对图像语义与细节的全面捕捉。它支持图文理解、图像生成、多模态对话、复杂指令执行等多种任务,并具备细粒度视觉处理能力。适用于内容创作、智能客服、教育、医疗及自动驾驶等多个领域。

GPT智库

一款强大的人工智能大模型综合应用,提供智能对话、文生图、图生图、音频翻译、图像分析和全球学术资料搜索等多种功能。

LayerDiffusion

LayerDiffusion是一种创新的AI工具,利用大规模预训练的潜在扩散模型生成具有透明度的图像。该技术引入了“潜在透明度”的概念,将图像的alpha通道透明度信息编码到潜在空间中。LayerDiffusion不仅可以生成单个透明图像,还能生成多个透明图层,支持条件控制生成和图层内容结构控制,确保高质量的图像输出。此外,它还能够生成多个透明图层,并通过共享注意力机制和低秩适应确保图层间的和谐混
jpghd

利用先进的人工智能 AI 将老照片无损高清修复

魔力工作室

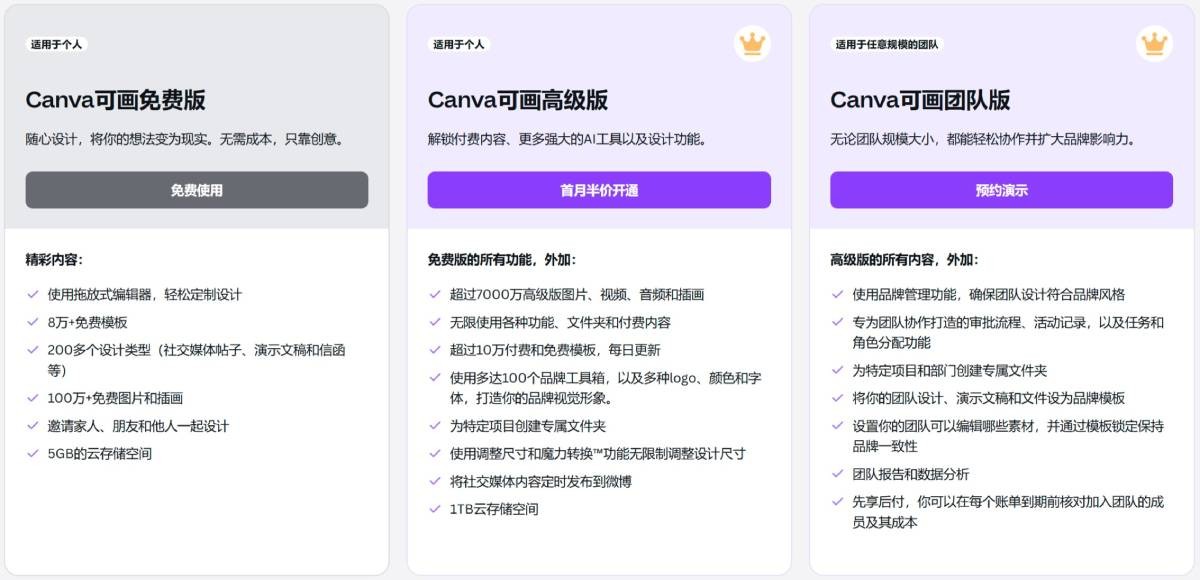
汇集了Canva可画最好的AI功能,帮助你以前所未有的轻松、快捷和创造力完成从第一次头脑风暴到成品的整个过程。

PixelFlow

PixelFlow是由香港大学与Adobe联合开发的图像生成模型,支持在像素空间中直接生成高质量图像。其基于流匹配技术和多尺度生成策略,实现从低分辨率到高分辨率的逐步生成,有效降低计算成本。该模型在类别条件图像生成和文本到图像生成任务中表现优异,具备强大的语义理解和视觉表达能力。此外,PixelFlow采用端到端训练方式,支持多种ODE求解器,适用于艺术设计、内容创作、教育研究等多个领域。

UniTok

UniTok是由字节跳动联合高校研发的统一视觉分词器,支持视觉生成与理解任务。其采用多码本量化技术,将视觉特征分割并独立量化,显著提升离散token的表示能力。在ImageNet上实现78.6%的零样本分类准确率,图像重建质量达0.38。可作为多模态大语言模型的视觉输入模块,广泛应用于图像生成、视觉问答、内容创作及跨模态检索等场景。

123APPS

一个可以在线编辑各种类型媒体文件的工具,包括视频、音频文件、PDF 和图像的转换,比如视频编辑器、屏幕录像机、文本到语音转换器、PDF 转换器和编辑器、音频编辑器、图像转换器、存档提取器和其他实用工具。

VModel

VModel是一款旨在实现高效且经济实惠的AI模特商拍产品,通过将模特摄影成本降低90%,有效的提升电商零售业的成功率。