多模态

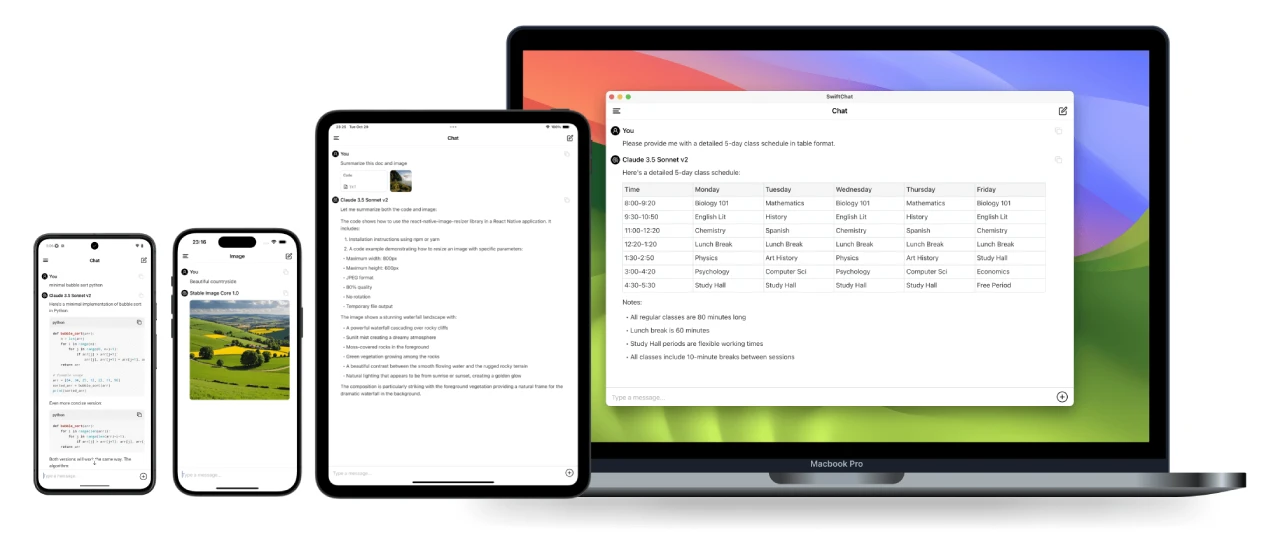
SwiftChat

一款基于React Native开发的快速、安全、跨平台聊天应用,支持实时流式聊天功能和Markdown语法,还可以生成AI图像,兼容DeepSeek、Amazon Bedrock、Ollama和OpenAI等模型。

Stackie.AI

Stackie.AI 是一款基于AI的智能记录与管理工具,支持多模态输入(文本、语音、图像),提供自动整理、任务生成、个性化模板及角色互动等功能。适用于健康管理、学习辅助、日常计划与习惯养成等场景,提升信息处理效率与用户体验。

LangBot

LangBot 是一款开源的多平台即时通讯机器人,支持多种主流通信工具及大语言模型。具备多模态交互、多轮对话、插件扩展和安全管理等功能,适用于企业客服、个人助理、社区管理、教育辅导和内容创作等场景,提供灵活、安全的自动化服务。

生数

生数以其创新的多模态大模型和深度生成式算法研究,为艺术设计、游戏制作、影视后期和内容社交等领域提供了强大的技术支持和解决方案。

VideoTuna

VideoTuna是一款基于AI的开源视频生成工具,支持文本到视频、图像到视频以及文本到图像的转换。它提供预训练、微调和后训练对齐等功能,兼容U-Net和DiT架构,并计划引入3D视频生成能力。VideoTuna旨在简化视频内容创作流程,提升生成质量与可控性,适用于内容创作、电影制作、广告营销、教育培训等多个领域。

Oryx

Oryx是一款由清华大学、腾讯和南洋理工大学联合开发的多模态大型语言模型,专为处理视觉数据设计。其核心技术包括预训练的OryxViT模型和动态压缩模块,支持任意分辨率的图像处理及高效的视觉数据压缩。Oryx在空间和时间理解上表现优异,广泛应用于智能监控、自动驾驶、人机交互、内容审核、视频编辑及教育等领域。

OpenVision

OpenVision是加州大学圣克鲁兹分校推出的多模态视觉编码器系列,具备从5.9M到632.1M参数的多种模型,适用于不同硬件环境。其采用渐进式多阶段分辨率训练策略,训练效率比同类模型高2至3倍,在多模态任务中表现优异。支持可变大小patch输入,兼具灵活性与高效性,广泛应用于工业检测、机器人视觉、自动驾驶及科研教育等领域。

书生·筑梦2.0(Vchitect 2.0)

书生·筑梦2.0是一款由上海人工智能实验室开发的开源视频生成大模型,支持文本到视频和图像到视频的转换,生成高质量的2K分辨率视频内容。它具备灵活的宽高比选择、强大的超分辨率处理能力以及创新的视频评测框架,适用于广告、教育、影视等多个领域。

EMMA

EMMA是一款基于Gemini模型的端到端自动驾驶多模态模型,可直接从原始相机传感器数据生成驾驶轨迹并执行多种任务,如3D对象检测、道路图元素识别及场景理解。该模型利用自然语言处理技术实现跨任务协作,并展现出强大的泛化能力,但在某些方面仍需改进。

StarVector

StarVector 是一个开源多模态视觉语言模型,支持图像和文本到可编辑 SVG 文件的转换。采用多模态架构,结合图像编码与语言模型,生成结构紧凑、语义丰富的 SVG 内容。基于 SVG-Stack 数据集训练,适用于图标设计、艺术创作、数据可视化等多种场景,具备良好的性能和扩展性。
