SpatialVLA SpatialVLA是一款由多机构联合研发的空间具身通用操作模型,具备强大的3D空间理解能力与跨平台泛化控制能力。通过Ego3D位置编码和自适应动作网格技术,实现精准的环境感知与动作生成。支持零样本任务执行与快速微调,适用于工业、物流、医疗等多个领域,推动机器人技术的发展与应用。 AI项目与工具 2025年06月12日 39 点赞 0 评论 810 浏览
DeepSeek R1 DeepSeek R1-Zero 是一款基于纯强化学习训练的推理模型,无需监督微调即可实现高效推理。在 AIME 2024 竞赛中 Pass@1 分数达到 71.0%,展现强大逻辑与数学推理能力。支持长上下文处理,具备自我进化、多任务泛化等特性,并通过开源和蒸馏技术推动模型应用与优化。 AI项目与工具 2025年06月12日 34 点赞 0 评论 810 浏览
Chaos® Vantage高阶应用 用实时光线追踪探索您的最复杂的3D场景。 使用 Chaos® Vantage,再也无需等待。只需要拖动完整的 V-Ray 场景到 Vantage 便可开始浏览。还可以与 3ds Max,SketchUp,Rhino,Revit ... 创作工具 2026年11月12日 0 点赞 0 评论 810 浏览
ToolBaz ToolBaz 是一款多功能的 AI 创作平台,涵盖文章撰写、故事生成、图像与视频制作、语音合成及代码编写等功能,旨在通过人工智能技术简化创作过程,提升内容质量和效率。无论是营销文案、社交媒体帖子还是产品描述,ToolBaz 都能快速生成高质量的结果,同时支持跨领域应用,如品牌宣传、客户服务和教育培训等。 AI项目与工具 2025年06月12日 14 点赞 0 评论 810 浏览
OpenVision OpenVision是加州大学圣克鲁兹分校推出的多模态视觉编码器系列,具备从5.9M到632.1M参数的多种模型,适用于不同硬件环境。其采用渐进式多阶段分辨率训练策略,训练效率比同类模型高2至3倍,在多模态任务中表现优异。支持可变大小patch输入,兼具灵活性与高效性,广泛应用于工业检测、机器人视觉、自动驾驶及科研教育等领域。 AI项目与工具 2025年06月11日 58 点赞 0 评论 810 浏览
代悟 代悟是一款基于深度学习技术和知识图谱的智能AI搜索引擎,专注于为开发者提供高效、精准的技术支持。它能够解析复杂的技术问题,提供代码示例、文档检索、错误诊断及性能优化建议等功能。代悟支持多语言开发环境,适用于代码开发、问题解决、技术学习及项目规划等多个场景。 AI项目与工具 2025年06月12日 52 点赞 0 评论 810 浏览
AnimateDiff AnimateDiff是一款由上海人工智能实验室、香港中文大学和斯坦福大学的研究人员共同开发的框架,旨在将文本到图像模型扩展为动画生成器。该框架利用大规模视频数据集中的运动先验知识,允许用户通过文本描述生成动画序列,无需进行特定的模型调优。AnimateDiff支持多种领域的个性化模型,包括动漫、2D卡通、3D动画和现实摄影等,并且易于与现有模型集成,降低使用门槛。 AI项目与工具 2024年01月01日 59 点赞 0 评论 810 浏览
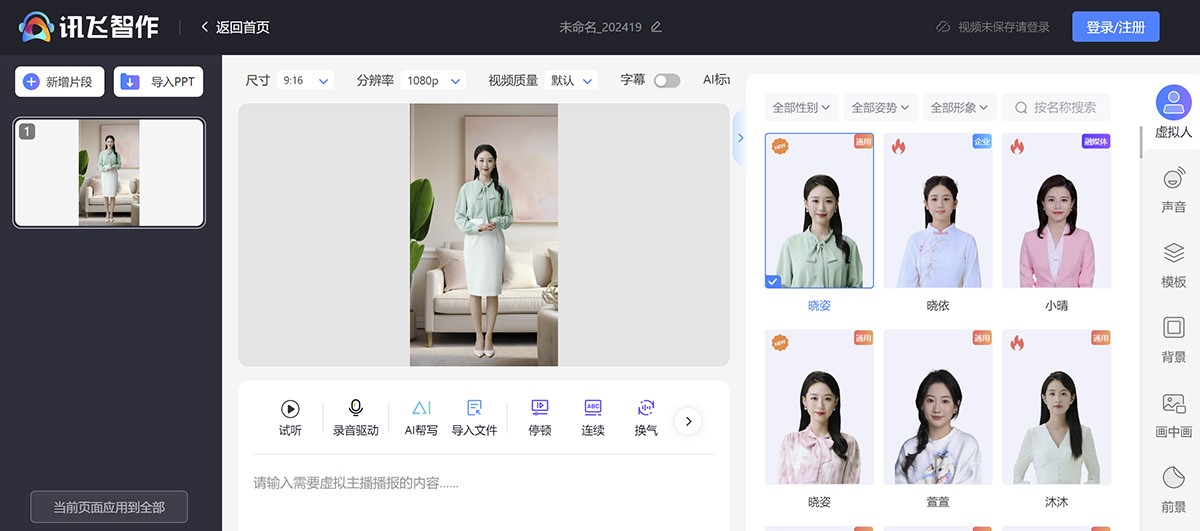
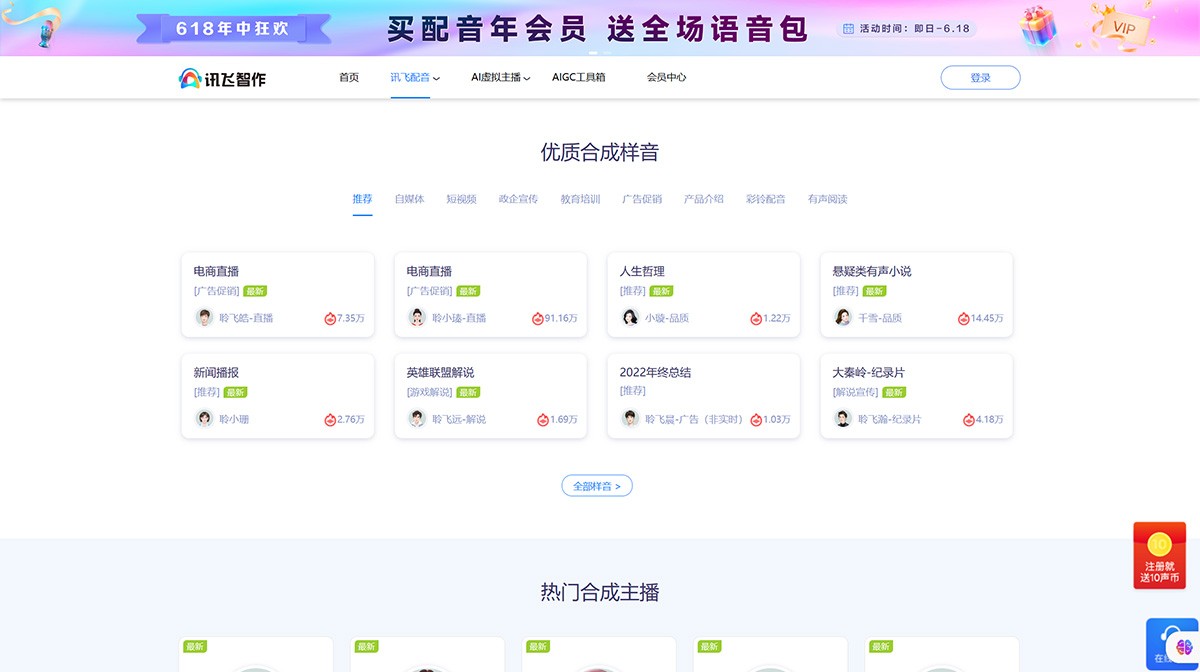
讯飞智作 一款集AI配音、虚拟数字人视频生成、PPT生成视频、数字人定制等多功能的AI音视频生产平台。已广泛应用于媒体、教育、短视频等领域。 Ai视频生成 2025年06月05日 64 点赞 0 评论 810 浏览
MuseGate MuseGate是一款依托生成式AI技术的电商营销工具,专注于服饰行业。它通过虚拟模特生成、场景定制、尺寸调整等功能,助力企业优化商品展示效果,降低运营成本,提升品牌形象。其核心功能包括虚拟模特生成、一键换装、场景定制、节点营销等,广泛应用于时尚展示、电子商务、广告宣传等领域。 AI项目与工具 2025年06月12日 68 点赞 0 评论 810 浏览