语音

FalcoCut

一款功能非常实用的多语言本地化AI视频生成与编辑工具,支持视频翻译、换脸、音频编辑、唇同步、数字人生成等功能。

Universal

Universal-1是一款由AssemblyAI开发的多语言语音识别和转录模型,经过大量多语种音频数据训练,支持英语、西班牙语、法语和德语等。该模型在各种复杂环境中提供高精度的语音转文字服务,具备快速响应能力和改进的时间戳准确性。Universal-1在准确率、响应时间、时间戳估计和用户偏好等方面表现优异,适用于对话智能平台、AI记事本、创作者工具和远程医疗平台等多个应用场景。

backseat ai

Backseat AI是一款面向《英雄联盟》玩家的AI语音辅助工具,提供实时游戏评论、购买建议、对线策略以及赛后分析等功能。它具有低资源占用、多语言支持和个性化语音包的特点,并与创作者共享收益,支持内容创作发展。
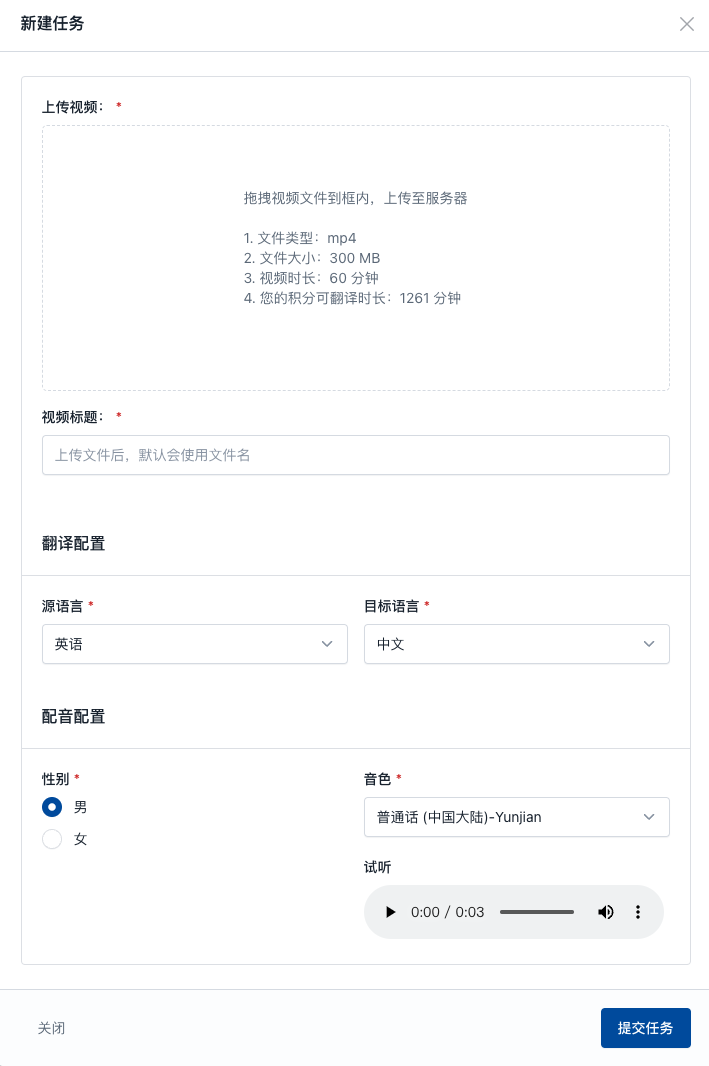
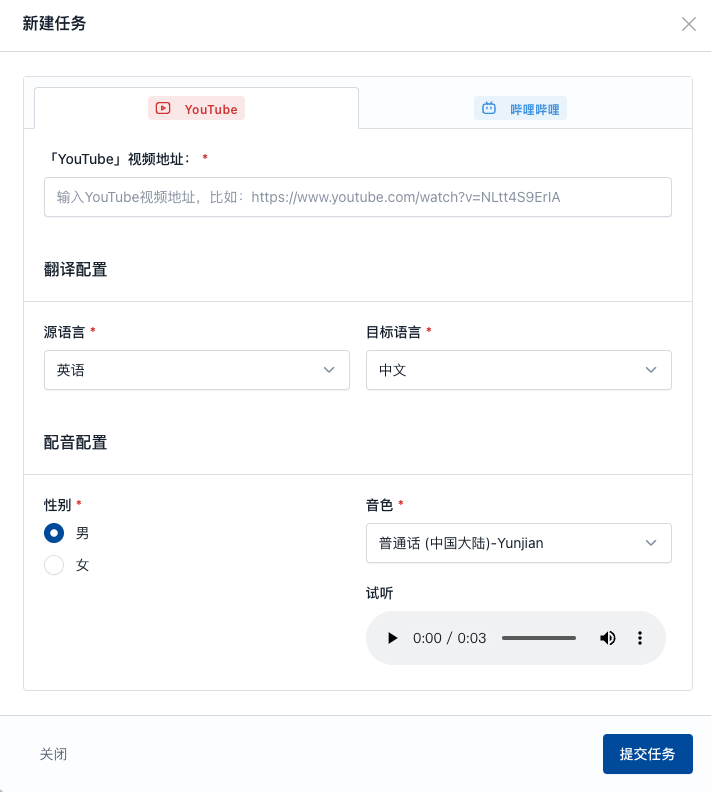
TransDuck

翻译+配音的一站式音视频处理解决方案,助力音视频创作者实现自动化的内容出海与内容引进。

Translate.Video

Video是一款视频翻译工具,用户可以轻松地将视频翻译成多种语言。该工具在一个易于使用的应用程序中提供自动字幕、字幕翻译、配音、AI画外音、录音和文本生成。

FireRedASR

FireRedASR是小红书推出的工业级自动语音识别(ASR)模型系列,支持普通话、中文方言和英语,具备高精度和高效推理能力。其包含FireRedASR-LLM和FireRedASR-AED两个版本,分别聚焦于极致精度和计算效率。模型在多个场景如智能助手、视频字幕生成、歌词识别和语音输入中表现出色,且已开源,推动语音识别技术的发展。

Actor Mode

Actor Mode 是由 ElevenLabs 开发的 AI 语音生成工具,支持用户通过自身声音生成风格一致的语音内容。它具备多语言支持、语音属性调节、即时生成等功能,适用于有声读物、视频配音、虚拟助手等多个领域。用户可通过录制或上传音频,让 AI 提取语音特征并生成符合要求的语音输出,提高创作效率与个性化表达。

LatentLM

LatentLM是一款由微软与清华大学合作开发的多模态生成模型,能够统一处理文本、图像、音频等多种数据类型。它基于变分自编码器(VAE)和因果Transformer架构,支持自回归生成与跨模态信息共享,特别擅长图像生成、多模态语言模型及文本到语音合成等任务,其提出的σ-VAE进一步提升了模型的鲁棒性。

星声AI

星声AI是一款智能化播客生成工具,支持文字、网页链接或文档输入,自动生成结构完整的播客脚本,并通过高质量语音合成技术转化为自然流畅的音频内容。平台支持中、英、日、韩四国语言,提供多种音色与风格选择,具备音频编辑、内容拆解、多平台发布等功能,适用于知识分享、企业培训、内容创作等多种场景。

EMOVA

EMOVA是一款由多所高校与企业联合研发的多模态全能型AI助手,具备处理图像、文本和语音的能力,支持情感化语音对话,并通过轻量级情感控制模块增强了人机交互的自然性。其核心技术包括连续视觉编码器、语义-声学分离的语音分词器及全模态对齐机制,广泛应用于客户服务、教育辅助、智能家居控制等多个领域。