图像

MiniMax

MiniMax-01是由MiniMax推出的高性能AI模型系列,包含语言模型MiniMax-Text-01和视觉多模态模型MiniMax-VL-01。该系列采用线性注意力机制,支持处理长达400万token的上下文,性能接近国际领先模型。具备强大的语言理解、多模态处理及长文本分析能力,适用于企业、教育、科研及开发等多个领域。API定价合理,提供高效的长文本处理与多模态交互解决方案。

SANA 1.5

SANA 1.5是由英伟达联合多所高校研发的高效线性扩散变换器,专用于文本到图像生成任务。其核心优势包括高效的训练扩展、模型深度剪枝、推理时扩展等技术,能够在不同计算预算下灵活调整模型性能。支持多语言输入,并具备开源特性,适用于创意设计、影视制作、教育等多个领域。实验表明,其生成质量接近行业领先水平,同时显著降低计算成本。

Firefly Video Model

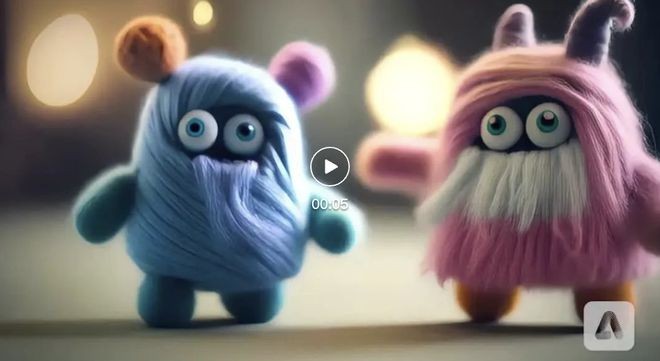
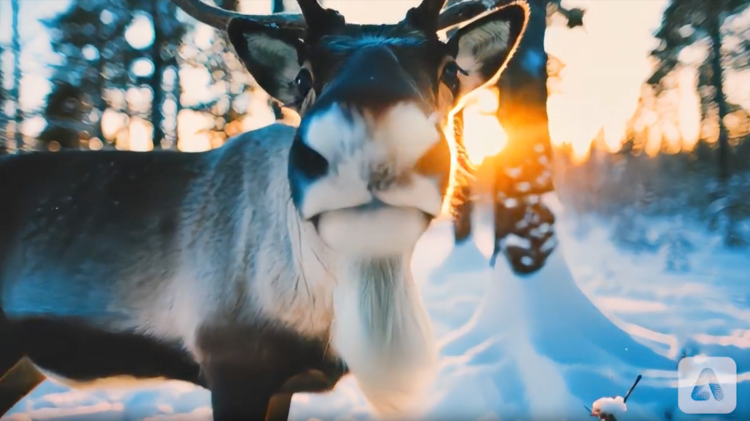
Adobe的新AI视频生成工具,建立在Firefly生成性AI图像模型基础上。Firefly Video Model提供文本到视频、图像到视频以及视频编辑功能,每次生成片段最长限制为5秒。

RenderNet AI

一款功能强大的图像和视频生成器,可对角色设计、构图和风格进行广泛控制。RenderNet Al可进行视频换脸,可轻松通过照片更改视频人物面容。

Squibler

Squibler是一款面向作家的AI辅助写作平台,支持小说、剧本、非小说等多种文体创作。用户可通过输入基本概念生成完整作品,平台提供模板选择、AI辅助写作、项目管理、视觉生成及协作功能。强调原创性与个性化,适合各类创作者使用,提供免费与专业版本选择。

Uncrop | 图片自动补全

UNCROP是一款在线AI图片自动补全工具。它利用强大的AI人工智能技术,能够帮助我们对图片进行扩展和自动补全,兼容上下、左右方向的扩充。
TheDoodleLibrary

一个特色鲜明的手绘图标和矢量图库网站,TheDoodleLibrary提供各种简约、可定制的手绘线条图像,涵盖概念、人物、动物、地点等多种主题。

TryOffDiff

TryOffDiff是一种基于扩散模型的虚拟试穿技术,通过高保真服装重建实现从单张穿着者照片生成标准化服装图像的功能。它能够精确捕捉服装的形状、纹理和复杂图案,并在生成模型评估和高保真重建领域具有广泛应用潜力,包括电子商务、个性化推荐、时尚设计展示及虚拟时尚秀等场景。
PIA

PIA是一款个性化图像动画生成器,可以生成具有高运动可控性和强文本和图像对齐性的视频,与条件图像对齐,通过文本实现动作控制,与各种个性化T2I模型兼容,无需特定调整。

SeaArt.Ai

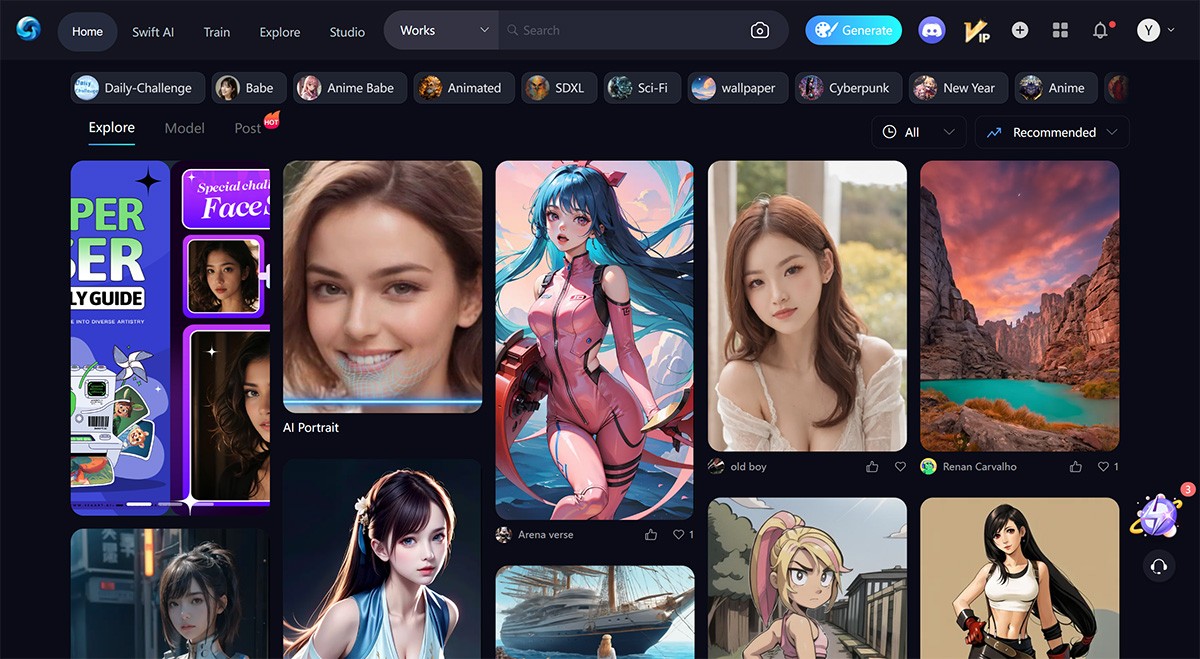
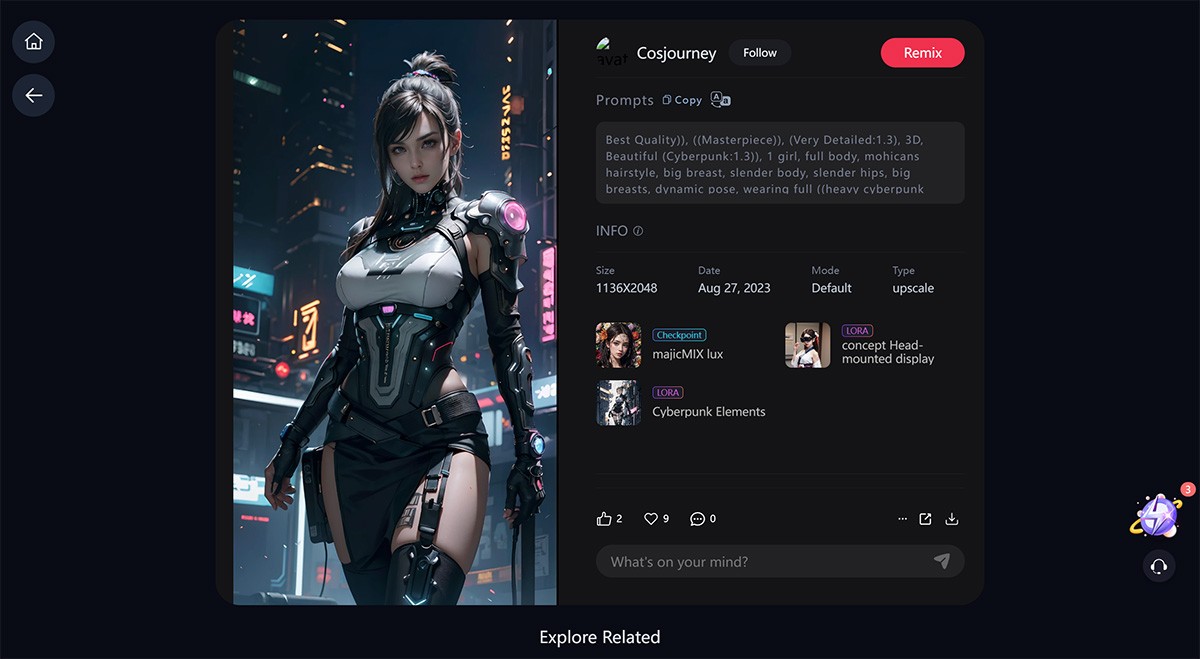
一款高效且用户友好的AI绘图工具,即使没有专业技能,您也可以立即成为艺术家。