图像

InternVL

InternVL是由上海人工智能实验室开发的多模态大模型,融合视觉与语言处理能力,支持图像、视频、文本等多种输入。其基于ViT-MLP-LLM架构,具备多模态理解、多语言处理、文档解析、科学推理等能力,广泛应用于视觉问答、智能客服、图像分析等领域。模型采用动态高分辨率与渐进式训练策略,提升处理效率与准确性。

FancyTech

一家专注于人工智能内容生成的公司,提供创新的AI平台,能够将产品图片转换成吸引人的、具有传播性的视频,从而将静态的视觉内容转变为动态且富有吸引力的形式。

VideoDrafter

一个高质量视频生成的开放式扩散模型,相比之前的生成视频模型,VideoDrafter最大的特点是能在主体不变的基础上,一次性生成多个场景的视频。

Cobra

Cobra是由清华大学、香港中文大学和腾讯ARC实验室联合开发的漫画线稿上色框架,采用因果稀疏注意力机制和局部可复用位置编码技术,实现高精度、高效率的自动上色。支持颜色提示调整,提升灵活性与个性化。适用于漫画、动画、插画等多种场景,具有高效的推理能力和良好的扩展性。项目已开源,包含技术论文与模型资源。

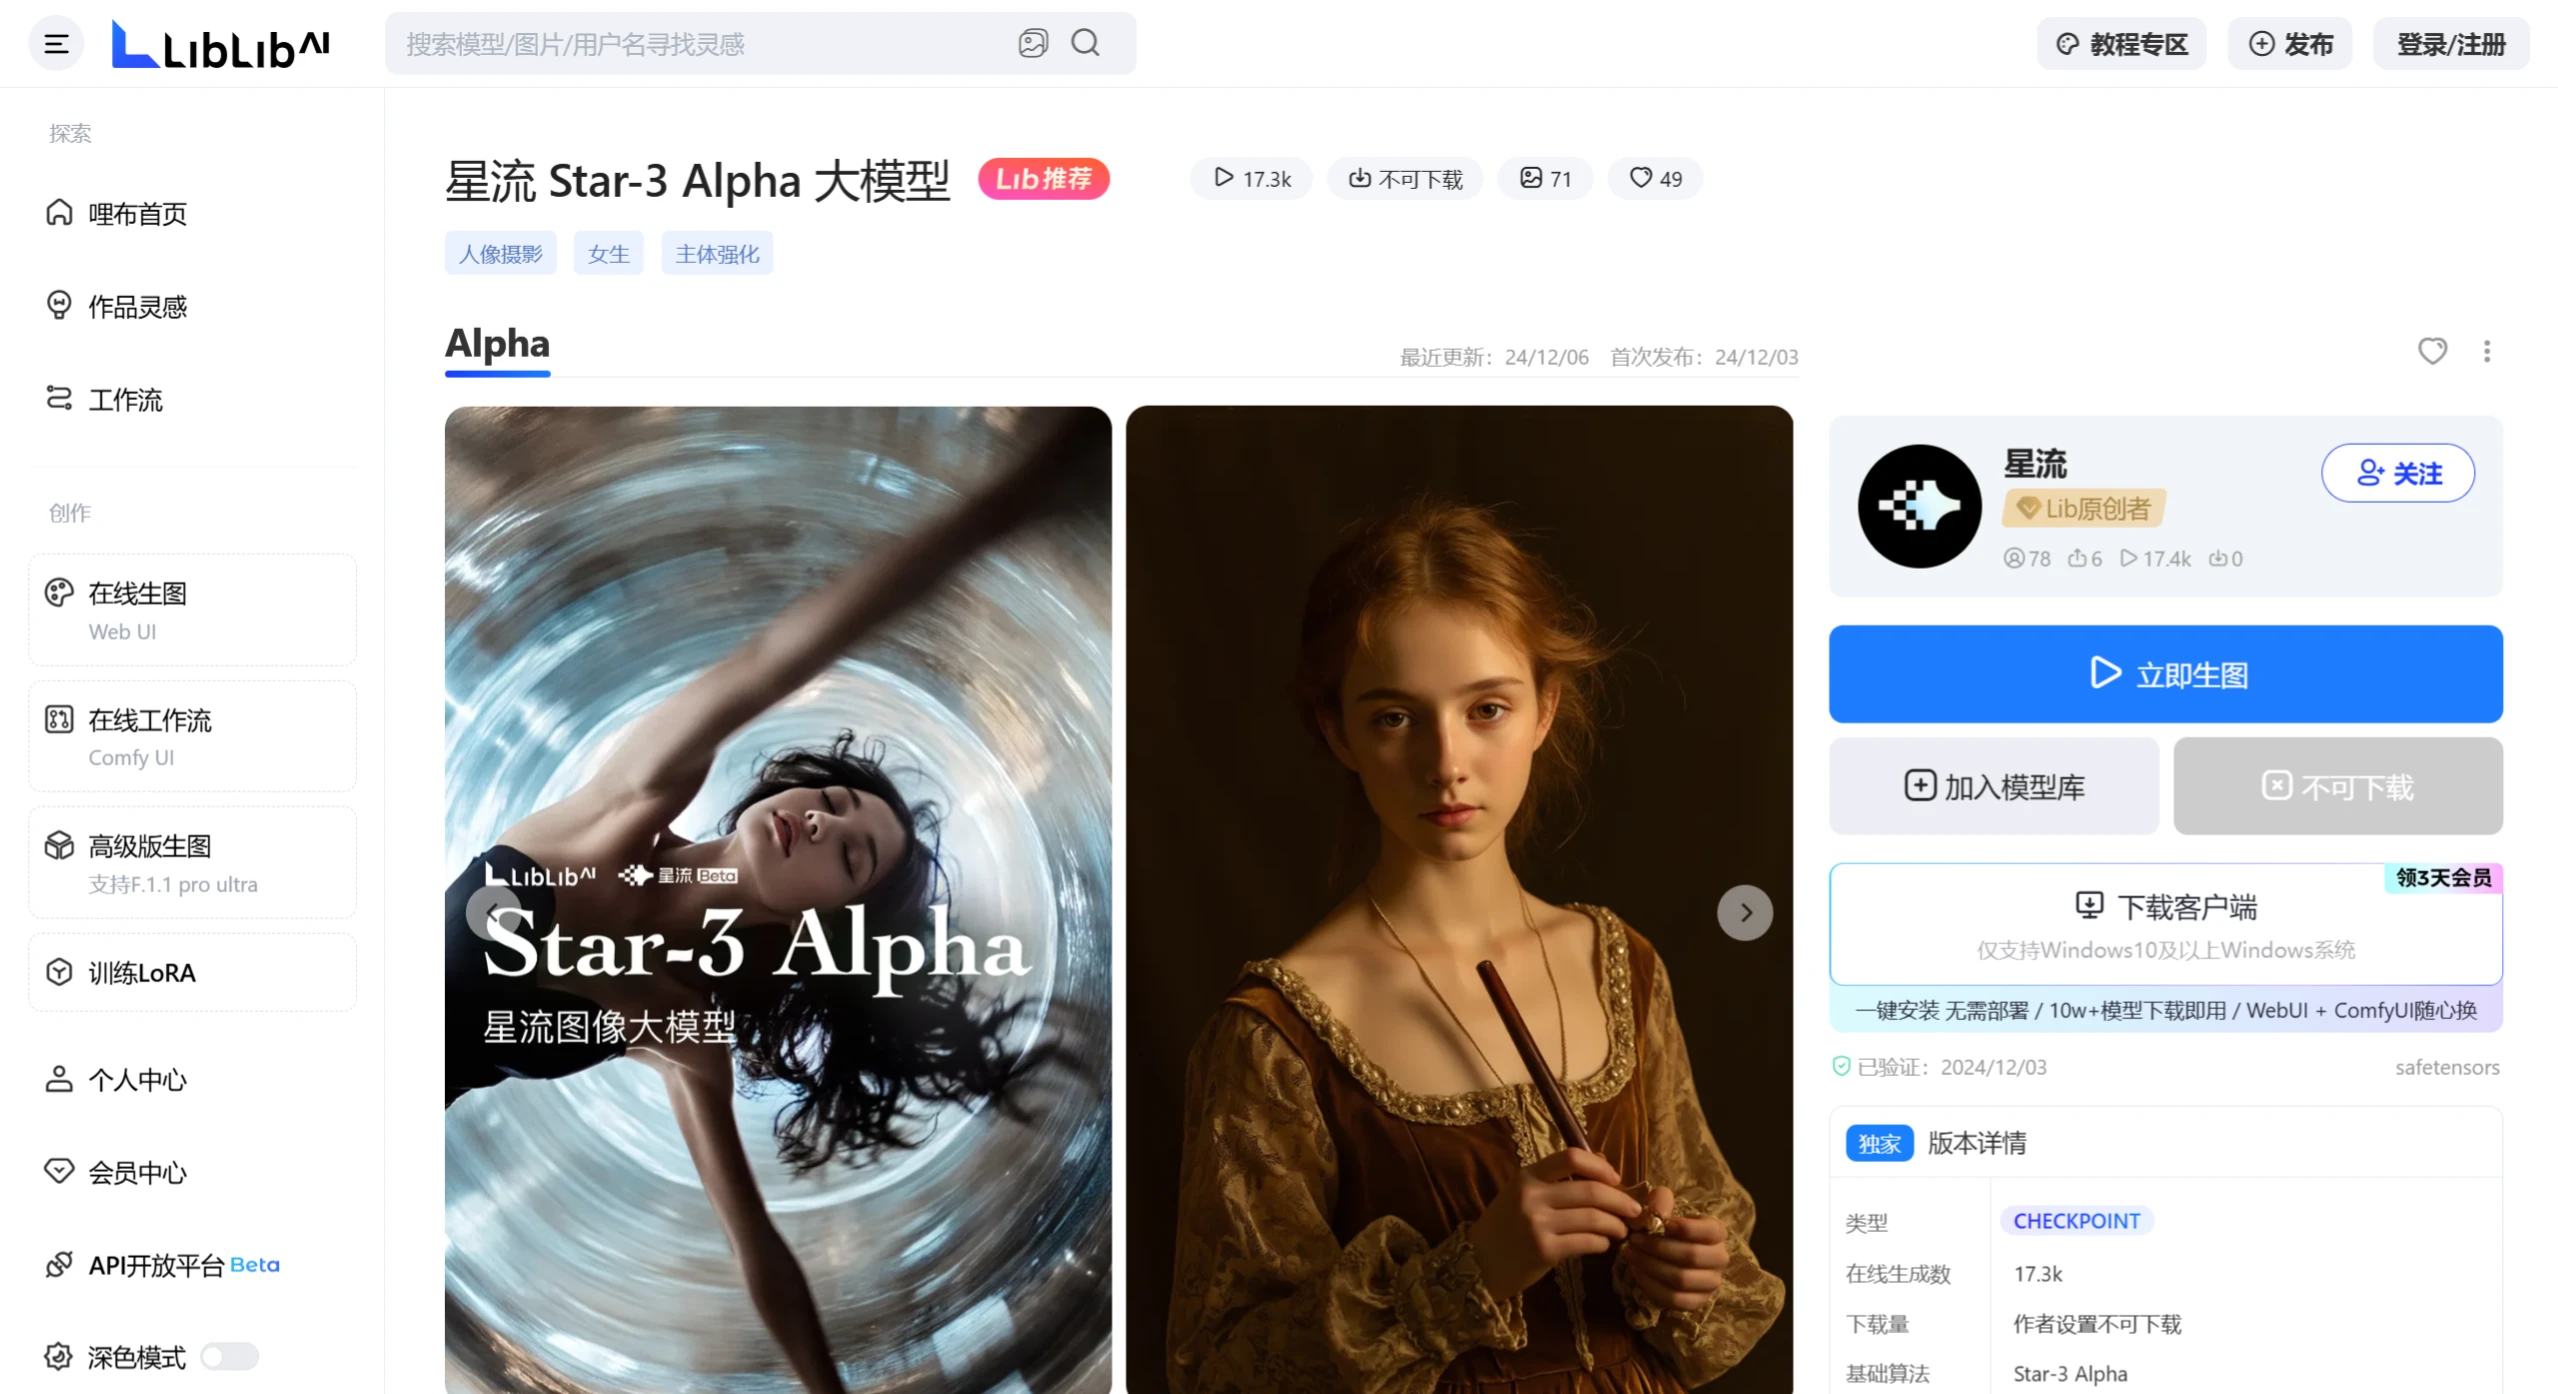
星流图像大模型

星流图像大模型是由LiblibAI发布的一款自研图像大模型,名为Star-3 Alpha。由LiblibAl团队于2024年启动研发,将于2025年Q1发布正式

Migician

Migician是一款由多所高校联合开发的多模态大语言模型,专为多图像定位任务设计。它基于大规模数据集MGrounding-630k,采用端到端架构和两阶段训练方法,支持跨图像精准定位与多任务处理。Migician适用于自动驾驶、安防监控、医疗影像等多个领域,具有高效的推理能力和灵活的输入方式。

Story

Story-Adapter是一种无需额外训练的长篇故事可视化框架,通过迭代优化和全局参考交叉注意力模块,提升图像生成的质量与细节表现。该工具适用于多种场景,包括故事创作、教育学习、娱乐游戏、广告营销以及影视制作等,特别适合需要将文字转化为视觉化内容的场合。

SynthLight

SynthLight是由耶鲁大学与Adobe Research联合开发的基于扩散模型的人像重照明工具,通过物理渲染引擎生成合成数据并结合多任务训练策略,实现高质量的光照效果生成。它能够根据环境光照图重新渲染人像,生成自然的高光、阴影和漫反射效果,并适用于摄影后期、虚拟场景、游戏开发及广告设计等多个领域,具备良好的泛化能力和实用性。


Qreates

高质量产品照片生成网站,用户只需通过Qreates输入简单的提示(如风格或氛围)就可以生成特定风格的产品照片,从而提升产品的吸引力。